
Ce mardi soir, en ouvrant mon outil de travail, le menu des modèles affichait une ligne grisée : Opus 5.5, avec un message sobre, « Mettez à jour Claude pour utiliser ce modèle sur cet ordinateur ». Une mise à jour plus tard, je travaillais dessus. Et la première chose que je lui ai demandée, c'est de vérifier le tableau de chiffres que son propre éditeur venait de publier. Un modèle d'Anthropic qui relit Anthropic : je sais ce que cela vaut. C'est pour cela que chaque constat de cet article renvoie à une source extérieure, listée en fin de page, et pas à l'avis du modèle sur lui-même.
La première relecture n'a trouvé aucune erreur de recopie. Il a fallu plusieurs passes, et la confrontation avec les classements publics et leurs archives, pour voir le reste : des réglages qui changent d'une colonne à l'autre, signalés en petits caractères ; un score marqué « partiel » sans être défini ; un modèle de la maison, Fable 5.1, crédité d'un score obtenu avec l'aide d'un autre ; et un classement tiers, celui de Zapier, révisé sans note de version. Si vous vous formez, si vous hésitez sur l'outil à apprendre ou sur le métier à viser, retenez d'abord ceci : ce que ce tableau ne dit pas compte autant que ce qu'il affiche.
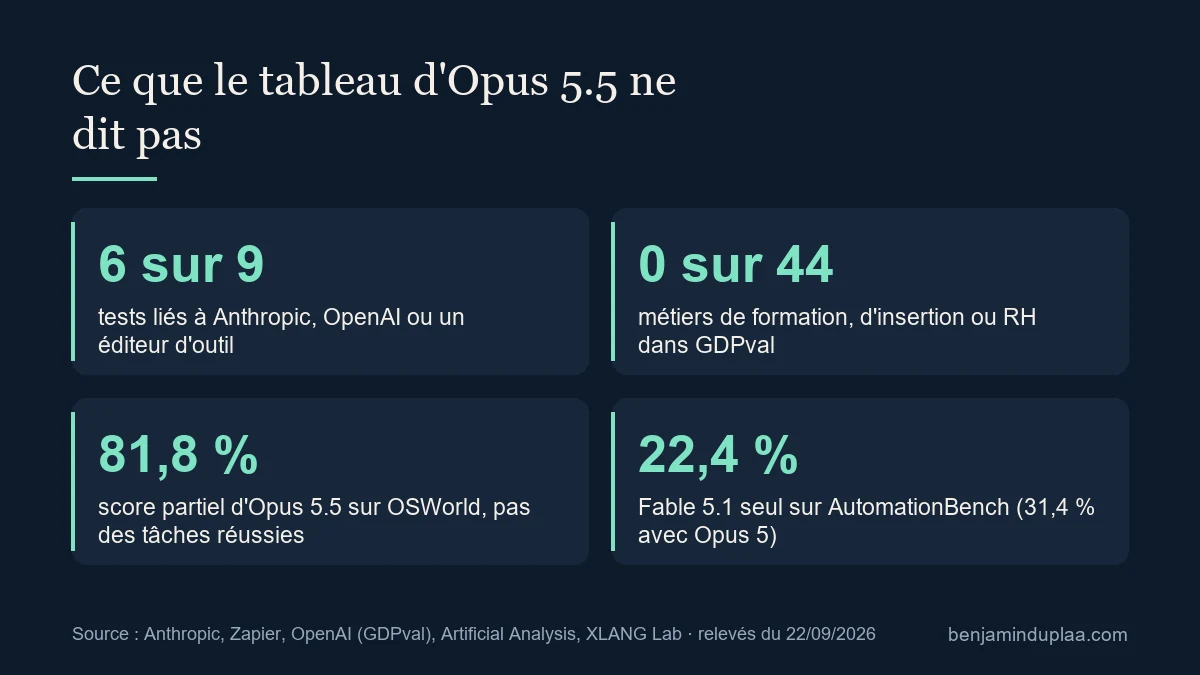
Anthropic a publié Claude Opus 5.5 le 22 septembre 2026, deux mois après Opus 5. Il arrive en tête sur sept des neuf tests du tableau de l'éditeur. Mais GPT-6 Astra, le dernier modèle d'OpenAI, n'y figure que sur six : sur ces six, c'est quatre à deux. Il coûte 20 % de moins par token qu'Opus 5 ; les « 40 % moins cher » sont, Anthropic le précise, un coût total sur des tâches types, mesuré dans ses propres tests. Six des neuf tests sont liés à Anthropic, à OpenAI ou à un éditeur d'outil, et le seul construit métier par métier, GDPval, ne compte aucun métier de la formation, de l'insertion ou des RH. Pour vous, la bonne mesure reste la vôtre : trois tâches de votre futur métier, et le temps qu'il faut pour corriger ce que l'outil produit.
Le tableau, et ce qu'il affirme
Voici le tableau tel qu'Anthropic le publie, traduit, avec une colonne ajoutée : « Ce qui est mesuré ». Neuf tests, cinq modèles : trois de la maison, deux d'OpenAI. Là où Anthropic met un tiret, je le garde : il veut dire « pas de chiffre dans ce tableau », pas « jamais mesuré ».
| Test | Ce qui est mesuré | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra | GPT-5.6 Sol |
|---|---|---|---|---|---|---|
| Terminal-Bench 4.0 | Programmation par un agent autonome | 66,4 % | 55,8 % | 52,3 % | 57,9 % | 37,3 % |
| FrontierCode v1.1 (Main) | Programmation par un agent autonome | 54,4 % | 50,3 % | 48,0 % | 53,3 % | 47,5 % |
| CursorBench 4.0 | Programmation par un agent autonome | 57,8 % | 51,8 % | 46,6 % | — | 41,7 % |
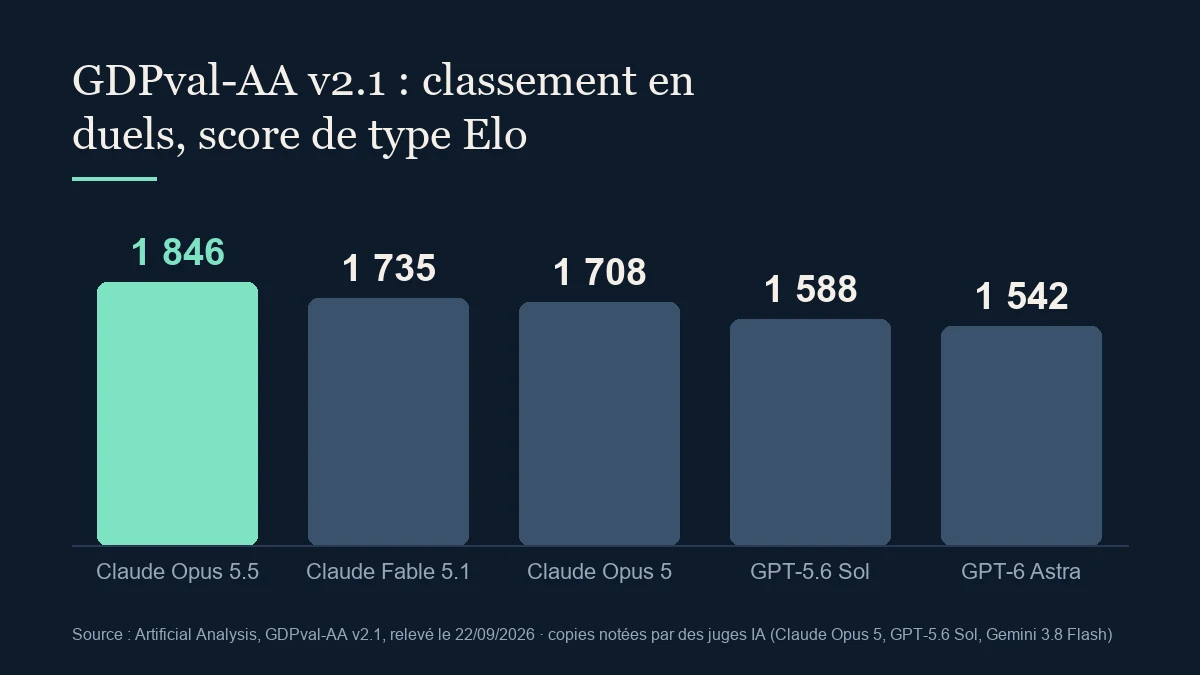
| GDPval-AA v2.1 | Travail de bureau qualifié (score de duel) | 1 846 | 1 735 | 1 708 | 1 542 | 1 588 |
| AutomationBench | Processus métier entre applications | 40,0 % | 31,4 % | 26,9 % | 41,4 % | 28,8 % |
| Humanity's Last Exam (avec outils) | Questions d'experts, toutes disciplines | 67,7 % | 65,6 % | 63,6 % | 57,2 % | — |
| Terminal-Bench-Science 0.1 | Recherche scientifique par un agent | 58,7 % | 52,6 % | 29,0 % | 64,6 % | 22,4 % |
| OSWorld 2.0 (score partiel) | Usage d'un ordinateur | 81,8 % | 80,7 % | 74,0 % | — | — |
| Chartography (avec outils) | Lecture de graphiques professionnels | 89,0 % | 88,4 % | 83,4 % | — | — |
Source : Anthropic, annonce de Claude Opus 5.5, 22 septembre 2026 [relevé le 2026-09-22]. Chiffres publiés par l'éditeur, mais pas tous mesurés par lui : ceux de GPT-6 Astra et de GPT-5.6 Sol sur Terminal-Bench 4.0, et celui d'Astra sur Terminal-Bench-Science, sont déclarés par OpenAI ; ceux d'OpenAI sur FrontierCode et Humanity's Last Exam, identiques à sa propre page, sont donnés sans source ; AutomationBench vient de Zapier, GDPval-AA d'Artificial Analysis. « Avec outils » et « score partiel » ne sont pas définis. Un tiret signale un chiffre absent du tableau, pas un test jamais passé : OpenAI publie par exemple 72,6 % pour GPT-6 Astra sur OSWorld 2.0, et Surge AI classe GPT-5.6 Sol à 45 % sur Chartography, selon d'autres protocoles. Les réglages ne sont pas identiques d'une colonne à l'autre (voir plus bas).
Lu tel quel, le tableau dit une chose simple : Opus 5.5 arrive en tête sur sept tests sur neuf. Il faut ajouter aussitôt que GPT-6 Astra, le modèle phare d'OpenAI, ne figure pas sur trois de ces sept (CursorBench, OSWorld, Chartography), et qu'aucun modèle d'OpenAI n'y figure sur les deux derniers. Face à Astra, sur les six tests communs, c'est quatre à deux : Astra garde l'avantage sur les processus métier et la recherche scientifique. Et sur deux de ces six, l'écart tient en moins d'un point et demi, dans un sens comme dans l'autre : FrontierCode pour Opus 5.5, AutomationBench pour Astra.
Le saut depuis Opus 5, sorti le 24 juillet, est net sur le papier : de 4 à 30 points sur les huit tests notés en pourcentage, et 138 points de classement sur GDPval-AA, en deux mois, tels que l'éditeur les mesure. Anthropic écrit pourtant lui-même, dans l'annonce, qu'à ce niveau les écarts de benchmark sont devenus un guide moins fiable des différences réelles, et qu'en usage interne l'écart entre Opus 5.5 et Fable 5.1 est plus étroit que ne le suggèrent les scores. C'est rare, un éditeur qui relativise son propre tableau. Il faut le prendre au mot.
Prix : 20 % par token, 40 % par tâche selon Anthropic
Opus 5.5 est facturé 4 dollars le million de tokens en entrée et 20 dollars en sortie, contre 5 et 25 pour Opus 5 : 20 % de moins par token, ce qu'Anthropic écrit lui-même. Les « 40 % moins cher » qu'il annonce aussi portent sur autre chose : un coût total, aux réglages par défaut, sur des charges de travail « typiques », parce que le modèle consomme aussi moins de tokens par tâche. Ce second chiffre vient des tests internes d'Anthropic, pas d'une mesure indépendante. La lecture du cache, quand un contexte déjà chargé est relu, passe de 0,50 à 0,20 dollar le million de tokens, et l'écriture dans le cache de 6,25 à 5 dollars. La génération est annoncée plus de 30 % plus rapide.
Pour un abonné, la nouvelle concrète est ailleurs : les limites d'usage sur cinq heures sont relevées pour les formules Pro, Max, Team et Enterprise au siège. Anthropic annonce aussi Sonnet 5.5 et Haiku 5.5 « dans les semaines à venir ». Autrement dit, la gamme aura encore bougé avant la fin de l'année, et elle bougera pendant toute la durée d'une formation.
Qui fabrique ces tests
Un benchmark n'est pas un thermomètre posé sur la table. Quelqu'un choisit les tâches, quelqu'un corrige les copies, et parfois quelqu'un paie. J'ai remonté chacun des neuf tests jusqu'à celui qui le publie.
| Test | Publié par | Lien d'intérêt relevé |
|---|---|---|
| Terminal-Bench 4.0 | Université Stanford et Laude Institute | Expériences du classement financées notamment par des subventions d'OpenAI et d'Anthropic |
| FrontierCode | Cognition (éditeur de Devin et Windsurf) | Éditeur d'outils de programmation ; son journal des modifications mentionne l'ajout de ses propres modèles au classement |
| CursorBench | Cursor | Éditeur d'outil qui distribue les modèles des deux éditeurs ; tâches non publiques, donc non vérifiables de l'extérieur ; classe aussi son propre modèle, loin derrière (27,7 %) |
| GDPval-AA | Artificial Analysis, sur un jeu de tâches créé par OpenAI | Copies notées par trois juges IA : Claude Opus 5, GPT-5.6 Sol et Gemini 3.8 Flash |
| AutomationBench | Zapier | Vend de l'automatisation entre applications ; a testé Opus 5.5 en accès anticipé, avant sa sortie publique |
| Terminal-Bench-Science | Stanford et Laude Institute | Crédits d'accès aux modèles fournis notamment par Anthropic |
| Humanity's Last Exam | Center for AI Safety et Scale AI | Scale AI fournit des données d'entraînement aux laboratoires |
| Chartography | Surge AI | Fournisseur de données d'entraînement aux laboratoires d'IA |
| OSWorld 2.0 | XLANG Lab, université de Hong Kong, avec plusieurs universités et entreprises | Aucun lien relevé avec Anthropic ou OpenAI ; don de Google Research, et parmi les auteurs Alibaba Qwen (éditeur de modèles) et Snorkel AI (fournisseur de données) |
Six tests sur neuf sont conçus, financés ou notés en partie par Anthropic ou OpenAI, ou publiés par un éditeur d'outil qui a un intérêt commercial dans ce qu'il mesure. Deux autres viennent de fournisseurs de données qui vendent aux laboratoires. OSWorld est le seul sans lien relevé avec les deux éditeurs comparés, sans être hors de toute attache : il reçoit un don de Google Research, et compte parmi ses auteurs Alibaba Qwen et Snorkel AI.
Un lien d'intérêt n'est pas une preuve de biais. Terminal-Bench est soutenu à la fois par OpenAI et par Anthropic. Sur GDPval, dont OpenAI a conçu les tâches, les deux modèles d'OpenAI arrivent derrière les trois modèles Claude ; dès la première édition, en 2025, un modèle d'Anthropic y était en tête. Rien de tout cela n'est caché : tout est public, et c'est ce qui permet de le vérifier. Mais personne ne le met dans le tableau.
Le seul test construit métier par métier
Plusieurs de ces tests partent de tâches réelles : des tickets de logiciels libres pour FrontierCode, des sessions d'utilisateurs pour CursorBench, des notes de frais et des demandes d'achat pour OSWorld. Un seul est construit métier par métier : GDPval. OpenAI l'a conçu en 2025 à partir de livrables de professionnels, qui avaient en moyenne quatorze ans d'expérience : un mémo juridique, un plan d'ingénierie, un plan de soins infirmiers. Quarante-quatre métiers, répartis dans les neuf secteurs qui pèsent le plus dans l'économie américaine. Une tâche y représente en moyenne près de neuf heures et demie de travail humain. Dans la version d'origine, des experts du métier comparaient à l'aveugle la copie de l'IA et celle d'un professionnel.
J'ai lu la liste des quarante-quatre métiers. Aucun ne relève de la formation, de l'accompagnement, de l'insertion professionnelle ou des ressources humaines. Pas de formateur, pas de conseiller en insertion, pas de chargé de recrutement. Le plus proche est un métier de travail social auprès des familles et des écoles. L'enseignement ne fait pas partie des secteurs retenus.
La version citée par Anthropic, GDPval-AA, change encore la règle du jeu. Les modèles y travaillent seuls, avec un terminal et un navigateur, et produisent documents, tableurs et diapositives. Mais ce ne sont plus des experts humains qui corrigent : ce sont trois modèles d'IA, Claude Opus 5, GPT-5.6 Sol et Gemini 3.8 Flash, de Google. Chaque éditeur comparé a donc un juge, et Google fournit le troisième. Ce sont toutefois des machines qui notent des machines, là où la version d'origine faisait juger des experts du métier. Le score qui en sort n'est pas un pourcentage de travail réussi. C'est un classement en duels, comme aux échecs : 1 846 veut dire « gagne plus souvent ses duels », pas « fait mieux qu'un professionnel ».
C'est la limite que ce site signale depuis la sortie de Fable 5.1, début septembre : aucun de ces tests ne mesure ce qui compte quand on se forme, l'exactitude d'une règle de financement, la patience d'une explication, la prudence devant un cas qui ne rentre pas dans les cases. GDPval s'en approche par la forme. Il ne s'en approche pas par les métiers.
Trois lectures qui changent le classement
Un score partiel n'est pas une tâche réussie
Sur OSWorld 2.0, l'usage d'un ordinateur, Opus 5.5 affiche 81,8 %. Le test comporte 108 tâches longues : notes de frais, demandes d'achat, réservations, mise en forme de présentations. Il faut à un humain un peu plus d'une heure et demie par tâche, en médiane. Son indicateur principal officiel est la réussite complète de la tâche. Le meilleur résultat publié dans l'article de recherche, avec Opus 4.8, est de 20,6 % de tâches réussies en entier, pour 54,8 % de score partiel. Les modèles ont progressé depuis : sur le classement public tenu par Snorkel AI, Opus 5 réussit en entier de 31 à 44 % des tâches selon la configuration, pour 68 à 78 % de score partiel [relevé le 2026-09-22]. Anthropic écrit bien « partial » à côté de chaque valeur, mais ne définit pas ce score, et ne publie pas de taux de réussite complète pour Opus 5.5. Ne lisez donc jamais « 82 % des tâches réussies ».
Un modèle aidé, l'autre pas
AutomationBench, publié par Zapier, est le test le plus proche d'un travail d'organisation : mener un vrai processus métier à travers plusieurs applications simulées, dans six domaines dont les ressources humaines, en tout ou rien. Le 31,4 % attribué à Fable 5.1 correspond, sur le classement de Zapier, à « Fable 5.1 avec repli sur Opus 5 » : Opus 5 y a traité environ 40 % des tâches. Seul, Fable 5.1 fait 22,4 %. Opus 5.5, lui, a été mesuré sans repli : chaque intervention de ses garde-fous comptait comme un échec, ce qui, selon Anthropic, abaisse son score. Cette asymétrie ne flatte pas Opus 5.5, elle réduit son avance ; OpenAI reprend d'ailleurs le même 31,4 % sur sa page de GPT-6 Astra.
Sources : Anthropic, 22 septembre 2026, et classement public de Zapier, version 1.0.6 [relevés le 2026-09-22]. Le 40,0 % d'Opus 5.5 vient de l'évaluation de Zapier pendant l'accès anticipé ; il ne figurait pas encore sur le classement public à la date du relevé.
Sur ce test de processus administratifs, GPT-6 Astra et Opus 5.5 sont donc au coude-à-coude : 1,4 point d'écart, à peine plus que la variation d'un passage à l'autre que Zapier annonce, de l'ordre de 1 %. Sans repli de part et d'autre, l'écart entre Opus 5.5 et Fable 5.1 double : 40,0 % contre 22,4 %. Mais le classement ne dit pas pourquoi Opus 5 a pris le relais de Fable 5.1 sur 260 tâches. Si ce sont ses garde-fous, une partie de l'écart mesure des refus, pas une capacité. Anthropic dit d'ailleurs, de son usage interne, que les deux modèles sont plus proches que leurs scores.
Des réglages différents d'une colonne à l'autre
Les scores d'Opus 5.5 sont pris à effort maximal, sauf mention contraire, le réglage le plus coûteux. Sur Terminal-Bench 4.0, Opus 5.5 est mesuré en effort « xhigh » et GPT-6 Astra en « high » : c'est le meilleur score publié de chacun, et ce n'est pas un handicap caché, puisque le classement public donne Astra à 58,2 % en effort maximal, trois dixièmes de plus. Sur FrontierCode, le réglage est au contraire le même pour tous, l'effort maximal. Mais ce n'est pas le meilleur de chacun : Opus 5 atteint 53,4 % à effort moyen sur le classement de Cognition, un point sous Opus 5.5. Le saut d'une génération à l'autre dépend donc du réglage retenu.
Sur les autres tests, Opus 5.5 a été évalué avec ses garde-fous de production actifs : quand ils se déclenchaient, Opus 4.8 prenait le relais sur la cybersécurité, et Opus 5 sur la biologie et le développement de modèles de pointe. Anthropic estime que cela abaisse probablement ses scores. Et Terminal-Bench 4.0 lui-même a été jugé « défectueux » par Epoch AI le 4 septembre, qui recense des défauts de notation signalés publiquement sur 30 de ses 66 tâches.
Un écart reste sans explication publique. Sur Terminal-Bench-Science, Anthropic donne 52,6 % à Fable 5.1, comme dès le 1er septembre, contre 40,0 % sur le classement public cité dans sa propre note : bien au-delà de la marge d'erreur. Sur Chartography, Anthropic signale « avec outils », sans dire lesquels. Ses scores, de 83 à 89 %, sont environ le double de ceux du classement de Surge AI, où le meilleur modèle atteint 46,2 %. Les deux séries ne se comparent pas : le protocole change l'épreuve.
Une correction sur nos propres chiffres
Le 1er et le 4 septembre, dans nos articles sur Fable 5.1, nous donnions 19,6 % à GPT-5.6 Sol sur AutomationBench. Anthropic écrit aujourd'hui 28,8 %. Ce n'est pas une faute de frappe : Zapier a révisé son classement entre le 16 août et le 3 septembre. Le score de Sol est passé de 18,1 % (version 1.0.5) à 19,6 % (version 1.0.6), puis à 28,8 % sous ce même numéro 1.0.6. Parmi les modèles déjà classés, seules les lignes GPT-5.6 ont bougé : c'est un nouveau passage de cette famille. Relancer un modèle n'a rien d'anormal, et le patron de Zapier a cité le nouveau chiffre publiquement dès le 3 septembre ; ce qui manque, c'est la trace dans le journal des versions. Notre graphique du 4 septembre mêlait donc un chiffre d'avant la révision et un chiffre d'après, et il présentait comme « déclarés par chaque éditeur » des scores mesurés par un tiers. Les deux articles portent désormais une note de correction.
Je le signale parce que c'est la leçon la plus utile de cette soirée. Un classement n'est pas une photo figée : c'est un document vivant, qui peut changer sans note de version, et que chacun recopie à une date différente. Un chiffre sans date de relevé ne vaut rien.
Ce que ça change pour vous
Si vous vous formez, si vous préparez une reconversion, ces neuf chiffres ne répondent pas à votre question. Même si vous visez l'informatique, où des tests comme Terminal-Bench s'approchent de votre futur poste, ils mesurent un agent qui travaille seul, pas un professionnel qui travaille avec lui. Votre question est : cet outil m'aide-t-il à faire le travail que je vise, et combien de temps me faut-il pour corriger ce qu'il produit ? Ce test-là, vous pouvez le faire en une demi-heure.
- Choisissez trois tâches réelles de votre futur métier. Pas des questions de culture générale : un livrable. Un compte rendu d'entretien, une procédure de dépannage, un courrier à un financeur.
- Donnez-les à l'outil avec le contexte qu'aurait un collègue, puis chronométrez le temps qu'il vous faut pour rendre le résultat présentable.
- Écartez sans discussion toute réponse qui contient une erreur grave : une règle de financement fausse, une manipulation dangereuse sur un serveur, un nom de dispositif qui n'existe plus. Une erreur critique annule dix bonnes réponses.
Ce qui prend de la valeur, ce n'est pas le modèle que vous choisissez : il aura changé avant la fin de votre formation. C'est la capacité à définir la tâche, à vérifier, à repérer l'erreur, et à assumer ce qu'on signe. C'est ce que j'appelle les métiers que l'IA valorise vraiment, et c'est pourquoi on peut se former à l'IA sans être technicien. La page IA et reconversion professionnelle rassemble les repères, et les métiers à envisager face à l'IA les pistes concrètes.
Une précision, parce qu'elle compte : je dirige un organisme de formation, IFPA Poitiers, qui prépare notamment le Titre Pro de technicien supérieur systèmes et réseaux. C'est l'un des métiers que visent directement des tests comme Terminal-Bench, où un agent travaille seul dans un terminal, et où la question « lequel apprendre » se pose en salle, pas en théorie. J'utilise au quotidien les outils des deux éditeurs, sur abonnement payant. Et cet article a été préparé avec Opus 5.5 lui-même, le modèle dont il parle : ses chiffres viennent des sources listées plus bas, pas de son jugement sur lui-même. Ma façon d'employer l'IA en formation d'adultes est décrite ici.
FAQ
Combien coûte Claude Opus 5.5 ?
4 dollars le million de tokens en entrée et 20 dollars en sortie, soit 20 % de moins par token qu'Opus 5 (5 et 25 dollars). La lecture du cache coûte 0,20 dollar par million de tokens, contre 0,50 pour Opus 5 ; l'écriture, 5 dollars. Les « 40 % moins cher » annoncés sont un coût total sur des usages typiques, estimé par Anthropic, qui ajoute à la baisse de prix une consommation de tokens plus faible.
Opus 5.5 est-il meilleur que GPT-6 Astra ?
Le tableau d'Anthropic ne compare les deux modèles que sur six tests. Opus 5.5 est devant sur quatre : programmation en terminal, FrontierCode, GDPval-AA et Humanity's Last Exam. GPT-6 Astra est devant sur deux : les processus métier (AutomationBench) et la recherche scientifique (Terminal-Bench-Science). Sur FrontierCode et AutomationBench, l'écart est inférieur à un point et demi. Sur les trois autres tests, Astra ne figure pas dans le tableau, et Anthropic reconnaît lui-même que les écarts de benchmark guident de moins en moins bien.
Où utiliser Opus 5.5 ?
Anthropic l'annonce « sur toutes les plateformes », dont Amazon Web Services, Google Cloud et Microsoft Azure, et propose son mode rapide dans Claude Code ; les limites d'usage sur cinq heures sont relevées pour les formules Pro, Max, Team et Enterprise au siège. Dans l'application, il peut falloir la mettre à jour pour qu'il apparaisse dans le choix des modèles.
Faut-il changer d'outil pour se former ?
Non. Le modèle que vous apprendrez à utiliser aura été remplacé avant la fin d'une formation de plusieurs mois. Ce qui se transfère d'un outil à l'autre, c'est la méthode : formuler la tâche, vérifier le résultat, repérer l'erreur. Faites votre propre test sur trois tâches de votre futur métier.
Sources
- Anthropic, « Introducing Claude Opus 5.5 », 22 septembre 2026, tableau, notes et tarifs [relevé le 2026-09-22].
- Anthropic, annonce de Claude Opus 5, 24 juillet 2026 : date et tarif [consulté le 2026-09-22].
- OpenAI, « GPT-6 Astra », 3 septembre 2026 : chiffres d'Astra et de Sol [consulté le 2026-09-22].
- Terminal-Bench 4.0 et revue d'Epoch AI, 4 septembre 2026 [consultés le 2026-09-22].
- Terminal-Bench-Science 0.1 et classement de Snorkel AI : Fable 5.1 à 40,0 % [consultés le 2026-09-22].
- Cognition, FrontierCode 1.1 et classement par niveau d'effort [consultés le 2026-09-22].
- Cursor, CursorBench [consulté le 2026-09-22].
- OpenAI, GDPval (Patwardhan et al., 2025) et Artificial Analysis, GDPval-AA [consultés le 2026-09-22].
- Zapier, classement AutomationBench, dépôt public et archive du classement au 16 août 2026 : GPT-5.6 Sol à 19,63 % [consultés le 2026-09-22].
- Center for AI Safety et Scale AI, Humanity's Last Exam [consulté le 2026-09-22].
- XLANG Lab, OSWorld 2.0, article de recherche et classement de Snorkel AI [consultés le 2026-09-22].
- Surge AI, Chartography et article de recherche [consultés le 2026-09-22].
La méthode de sourçage appliquée sur ce site est décrite sur la page Sources et méthodologie.
🔗 Aller plus loin
- Fable 5.1 face à GPT-6 Astra
- Claude Fable 5.1 et Mythos 5.1 : ce qui change
- Le classement des dix meilleurs modèles au 17 août
- Métiers que l'IA valorise vraiment
- Se former à l'IA sans être technicien
- IA et reconversion professionnelle
- Les métiers à envisager face à l'IA
- La formation professionnelle pour adultes
Vous hésitez sur l'outil à apprendre, ou sur le métier à viser face à l'IA ? Faire mon bilan gratuit · 3 min : sept questions pour situer où vous en êtes, avant d'engager du temps ou de l'argent. Et si votre situation ne rentre dans aucune case, écrivez-moi.
Soyez libre de vos pensées et de vos décisions, toujours.